muse/dots/manus 2.0,以及(无人关心的)openclaw 2.0
PUBLIC
从3月份到9月份,从openclaw的爆火,到各家都推出了自己的集成化产品。
使用AI的侧重点也跟着发生了变化,讲讲新一轮刷新工具之后的一些特性:
连续数天连续工作的能力,记忆层,远程访问的体验,笔记本和手机任务接力,数据备份。
以及影响更深远的,GPT-6-Astra对具身模型的影响。
几个使用模式
[强]能够比较长时间的工作 如果选一个指标来评价AI的进步,可能会使用自主工作的时间长度。
Devin在2024年3月13发布的时候,就是希望做一个完全异步的工作流。 回想起来那个时候还是比较难的。
今天讨论这个问题,可能大家反而会觉得,Coding Agent本应该能连续工作。
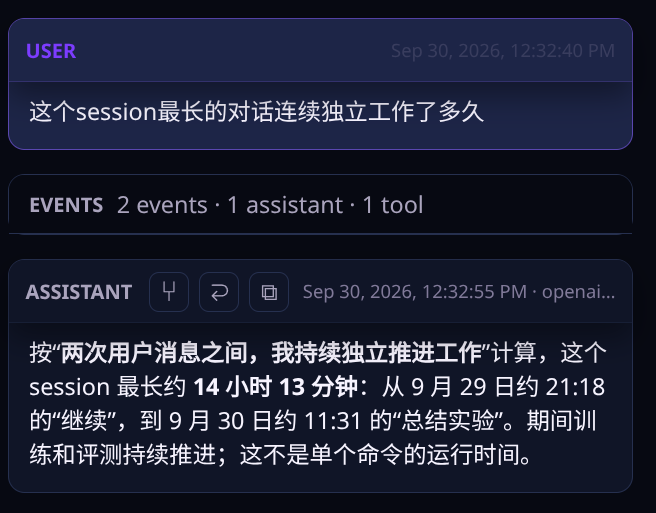
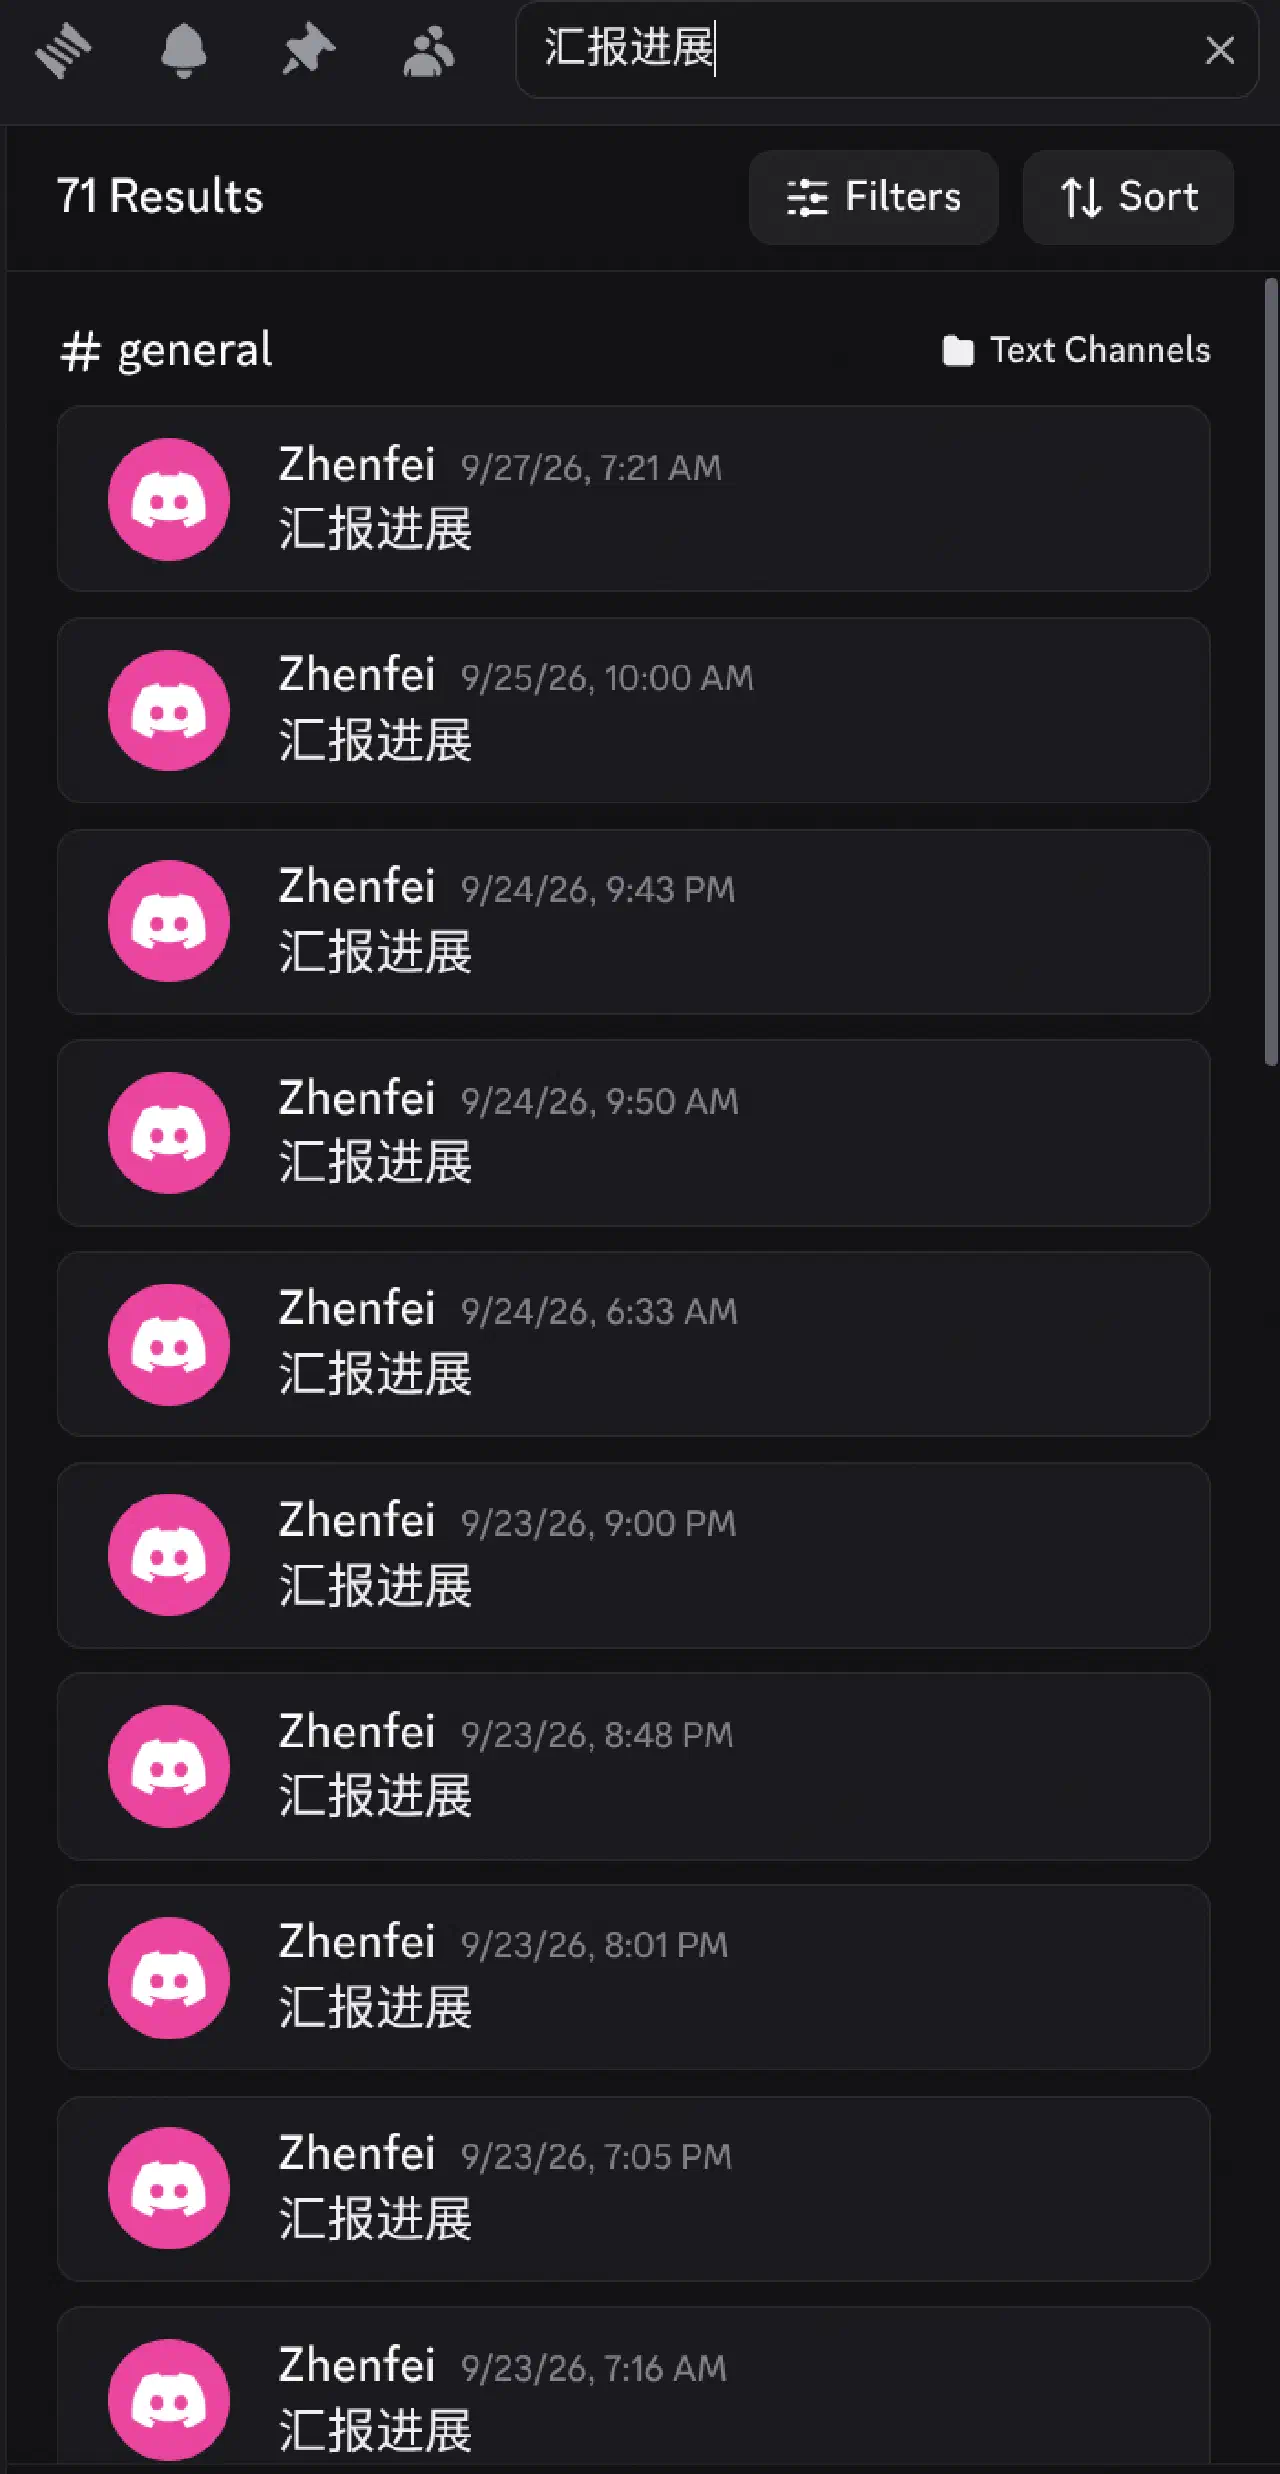
不过我现在也不知道是为什么。。。其他agent可能都符合这个需求。
[强]能在VPS常驻,并手机访问,有通知
为什么openclaw在上面提到有这么严重的问题,还在用。。
就是因为适应了discord这个界面:
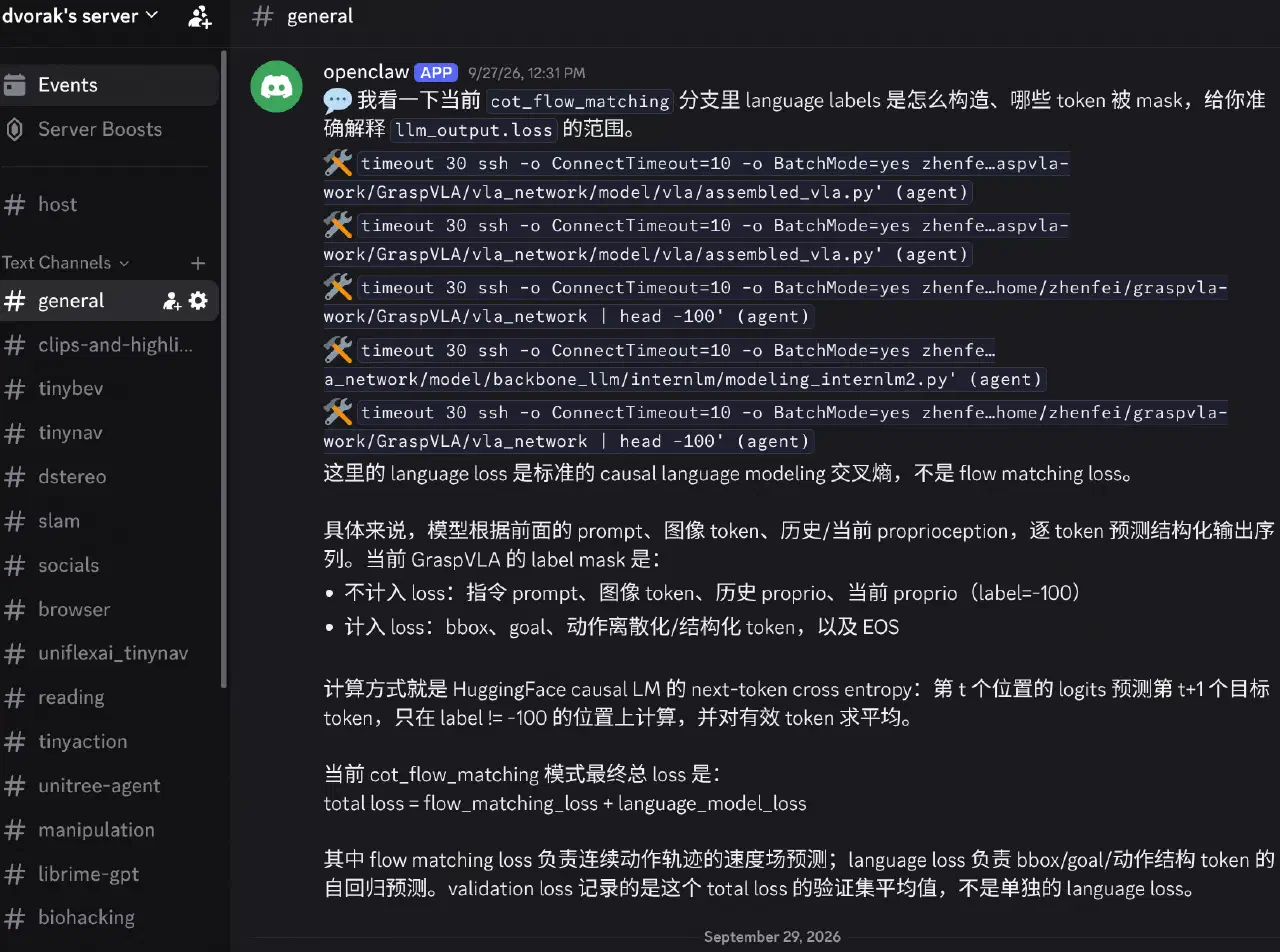
完美符合,还有一个很清晰的project/workspace/session管理,有通知。
新方案里面用pi-web,通过tailscale serve可以用类似https://ubuntu-s-1vcpu-2gb-sfo3-01.taile1547.ts.net/形式的链接访问。
但是没有通知。
[中]同一个任务,手机和笔记本可以接力工作 discord和pi-web都满足。
其中不满足的反而是Codex的remote,可能是一个短期的问题,但是当前Codex的Linux客户端没有Remote标签。
所以可以用手机连接VPS上的codex,但是笔记本反而不行,web和cli和desktop都不行。
[强]比较好的记忆
openclaw给我的感觉一个是比较复杂:
{
  plugins: {
    entries: {
      "memory-wiki": {
        enabled: true,
        config: {
          vaultMode: "isolated",
          vault: {
            scope: "global",
            path: "~/.openclaw/wiki/main",
            renderMode: "obsidian",
          },
          obsidian: {
            enabled: true,
            useOfficialCli: true,
            vaultName: "OpenClaw Wiki",
            openAfterWrites: false,
          },
          bridge: {
            enabled: false,
            readMemoryArtifacts: true,
            indexDreamReports: true,
            indexDailyNotes: true,
            indexMemoryRoot: true,
            followMemoryEvents: true,
          },
          unsafeLocal: {
            allowPrivateMemoryCoreAccess: false,
            paths: [],
          },
          ingest: {
            autoCompile: true,
            maxConcurrentJobs: 1,
            allowUrlIngest: true,
          },
          search: {
            backend: "shared",
            corpus: "wiki",
          },
          context: {
            includeCompiledDigestPrompt: false,
          },
          render: {
            preserveHumanBlocks: true,
            createBacklinks: true,
            createDashboards: true,
          },
        },
      },
    },
  },
}
实际体感好像也不够好。比如经常忘记
ssh zhenfei@100.90.100.64还是ssh root@100.90.100.64。codex反而默认的配置好像就比较好。
总结来看,现在的记忆好像也经历了一次变化,整体趋势都是更多的交给模型去做。
古早的做法是Vector retrieval,需要传一个embedding API。
典型代表有mem0:
写入 add(对话, user_id):
    最近消息 = 读取该会话最近 10 条消息
    旧记忆 = 在该用户范围内,向量检索最相关的 10 条记忆

    新事实 = LLM(对话, 最近消息, 旧记忆)
    # LLM 从用户和助手消息中提取值得记住的事实;
    # 旧记忆用于判断哪些事实已经记过

    for 事实 in 新事实:
        if 与旧记忆语义重复: 跳过    # 主要由 LLM 判断
        if MD5(事实文本) 已存在: 跳过 # 精确去重
        向量 = embed(事实文本)
        批量存入向量库(事实, 向量, user_id, 时间等元数据)
        记录变更历史、提取并关联实体
    保存最近消息
读取 search(问题, user_id):
    候选 = 向量检索(问题, user_id)
    关键词分 = BM25(问题)
    实体加分 = 匹配问题中的实体
    对候选计算综合分 = (语义分 + 关键词分 + 实体加分) / 可用信号的最大分
    过滤过期和低于语义阈值的候选
    返回 Top-K(可选重排)
更潮流的实现可能反而是rg-based,比如codex的:
Codex session / rollout │ ▼ ┌─────────────────────┐ │ Phase 1: Extraction │ │ LLM 提取 raw memory │ └──────────┬──────────┘ │ ▼ SQLite state DB │ ▼ ┌─────────────────────────┐ │ Phase 2: Consolidation │ │ 后台 Agent 整理 Memory │ └────────────┬────────────┘ │ ▼ ~/.codex/memories/ │ ┌──────┴───────┐ ▼ ▼ memory_summary.md MEMORY.md │ ▼ topic / skills / files │ ▼ Codex Agent单独的saas实现有字节的OpenViking,甚至把做了一个vfs的抽象:
                   OpenViking
                     │
     ┌───────────────┼───────────────┐
     ↓               ↓               ↓
文件系统语义层      精确检索层        向量检索层
viking://...       grep/glob       Embedding
     │                               ↓
L0/L1/L2                         Vector Index
     │                               │
     └───────────────┬───────────────┘
                     ↓
                  Recall
[弱]能比较好的备份
本来的想法是备份“记忆”,发现记忆现在没有形成共识。
另外的想法就是备份对话记录了,可以用self-host stift:
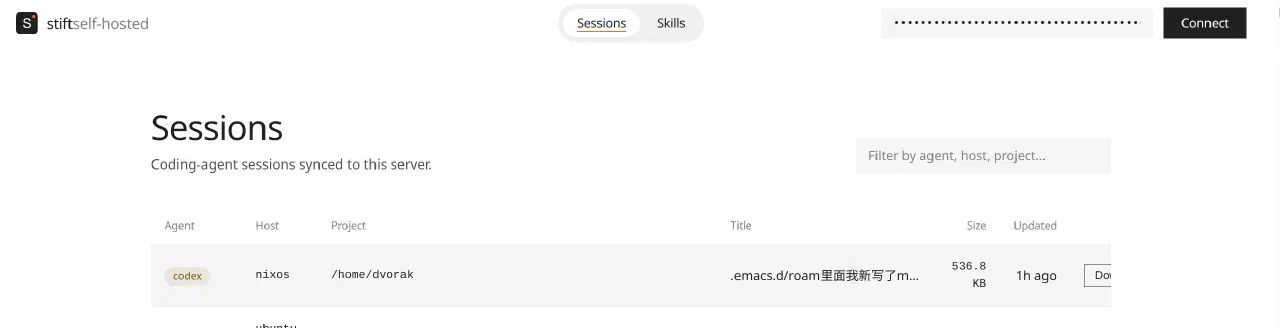
这个时候就觉得openclaw把会话存储改成sqlite很奇怪了。
[负分] 会不会进故纸堆了 一些所谓的agent特性,会不会慢慢都消失掉了。
从A社精简system_prompts到codex删除/todos。
现在哪些命令依旧是有用的:
- goal mode/plan mode:好像基本没用了
- subagent:很多时候可以被AI自主的起后台任务代替
- RAG:上面提过了,相比rg-based momory来说,更难融入LLM训练过程
- skiils:也许会被自己提炼的记忆代替,或者agent的通信板代替
仿真是RSI吗
如果说很多硬件相关的调试还是人作为瓶颈,是不是仿真或者说特指sim2real应该能完全自主地优化。
短期的milestone也许是,工作了100个小时之后,发了一个固件可以让QA去测试抓取。
因为目前的抓取整体上是依赖仿真数据的,(但是评价不是)。
GPT-6-Astra是怎么做的
可能单纯是,让模型去学习了所有的任务:
- 写诗
- 写代码
- 传统几何
- 闭环控制
- 衣服
- 抽屉
- 导航
如果所有我们认为的子领域的任务,都是OpenAI训练GPT-6的一类数据呢。
很荣幸成为bootloader的一环。
对我们来说,还是要快速论证,任务和数据的关联关系,模型只是验证这个关联关系的手段。